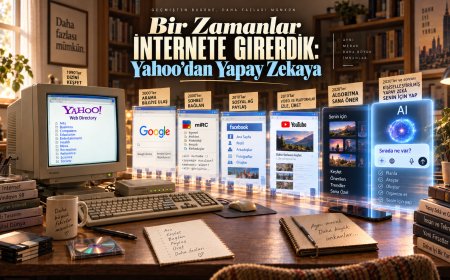



Bir Zamanlar İnternete Girerdik: Yahoo'dan Yapay Zekaya
Bir zamanlar internete ‘girerdik’. Yahoo’dan ilk YouTube videosuna, Copernic’ten yapay zeka ajanlarına otuz yılın hikayesi ve eğitimin bu hikayedeki yeri.
 Berkay Batallı
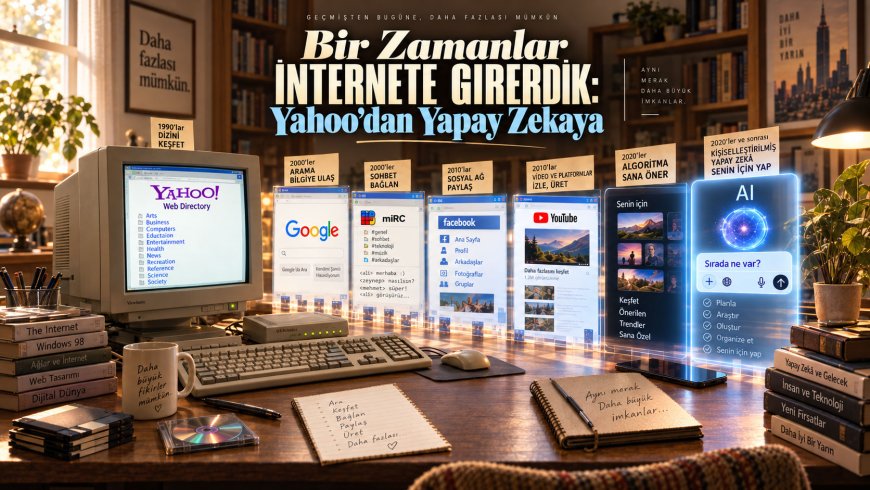
Önce internette nereye gideceğimizi aradık. Sonra bilgiyi bulmayı öğrendik. Birbirimizi bulduk, kendimizi göstermeye başladık, yayıncı olduk, algoritmaların bize ne göstereceğini seçmesine alıştık. Şimdi yeni bir eşiğin önündeyiz: İnternet artık yalnızca cevap vermiyor; bizi tanıyor, bizim için araştırıyor ve giderek bizim adımıza işler yapıyor. Otuz yılı biraz aşan bu hikaye yalnızca teknolojinin değil, insan davranışının, öğrenmenin, çalışmanın ve fırsatların da hikayesi.
Bir dönem internete gerçekten “girerdik.” Bu ifade bugün kulağa tuhaf geliyor, çünkü artık internetten çıkmıyoruz ki tekrar girelim. Sabah uyandığımızda telefon bağlı, saat bağlı; televizyon, otomobil, iş uygulamaları, banka, müzik, fotoğraflar, toplantılar bağlı. Günün büyük bölümünde internetin nerede başlayıp nerede bittiğini düşünmüyoruz bile.
Bir zamanlar öyle değildi. Bilgisayar açılır, modemin telefon hattına bağlanması beklenirdi. O kendine özgü elektronik sesler duyulur, birkaç saniyelik küçük bir seremoni tamamlanır ve başka bir dünyaya geçildiği hissedilirdi. İnternete bağlanmak başlı başına bir eylemdi. Üstelik bağlandıktan sonra bugün son derece basit görünen bir soru beklerdi: Şimdi nereye gideceğiz?
Bugün bir çocuğa bunu anlatmak kolay değil. Arama motorunun olmadığı, sosyal medya akışının olmadığı, telefonun kullanıcısını tanımadığı, algoritmanın önüne sürekli yeni şeyler koymadığı bir internet. Orada olmak yetmiyordu; yolu da insanın kendisi bulmak zorundaydı.
İnternetin son otuz küsur yıllık hikayesini anlamanın en iyi yolu belki de tam buradan başlıyor. Çünkü bu süre boyunca teknoloji hep aynı şeyi yaptı: Önümüzde duran bir zorluğu biraz daha azalttı. Biz de teknoloji kolaylaştıkça davranışlarımızı değiştirdik. Sonra o yeni davranış, daha önce var olmayan fırsatları doğurdu. Ve neredeyse her seferinde, çözülen problemin arkasından yeni bir problem çıktı. Bugün yapay zeka konusunda yaşanan heyecanı, endişeyi ve belirsizliği anlamak için biraz geriye bakmak gerekiyor. Çünkü buraya bir gecede gelinmedi.
Önce bize bir harita gerekti
1990'ların başı. World Wide Web henüz çok genç. Tim Berners-Lee'nin CERN'de geliştirdiği sistem 1991'de daha geniş çevrelere açılmaya başlamış, CERN de 30 Nisan 1993'te web yazılımını kamuya açık hale getiren kararı vermişti. Web büyümeye başlamıştı. Ama büyüyen bir şeyin çok temel bir problemi vardır: Bir noktadan sonra içinde kaybolursunuz.
1994'te Stanford'da Jerry Yang ve David Filo'nun oluşturduğu web rehberi tam olarak bu probleme cevap veriyordu. Daha sonra Yahoo adını alacak sistemin mantığı bugünkü internet kullanıcısına şaşırtıcı derecede basit gelebilir: Web siteleri konularına göre sınıflandırılıyor, kullanıcı da bu kategoriler arasında ilerliyordu. Education. Tıklayın. Alt kategori. Bir kez daha tıklayın. İlgili siteler. Bir bakıma dev bir kütüphanenin katalog çekmeceleri arasında dolaşıyorduk.
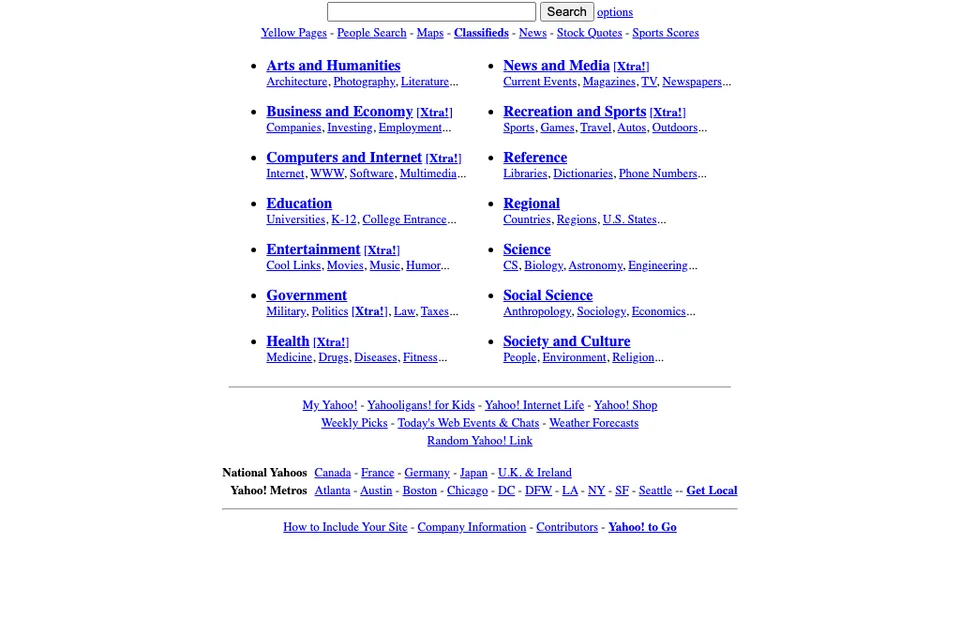
O günün problemi açısından bu çok değerliydi. İnternet büyüyordu ve birileri onun haritasını çıkarıyordu. Buradaki ilk dönüşüm teknolojiden çok zihinseldi: İnternet artık yalnızca bilgisayarların birbirine bağlandığı teknik bir ağ değil, içinde keşfedilecek yerlerin bulunduğu bir dünya haline geliyordu. Bununla birlikte yeni bir ekonomik değer doğdu: Kürasyon. İnsanların önündeki seçenekler çoğaldıkça “hangisine bakmalıyım?” sorusunun cevabı değer kazandı. Bu fikir kaybolmadı; Netflix'in ne izleyeceğimizi, Spotify'ın ne dinleyeceğimizi, sosyal medya algoritmalarının ne göreceğimizi seçmesine kadar uzanan uzun hikayenin ilk izlerinden biri burada.
Büyük fırsatlar çoğu zaman yeni teknoloji icat etmekten değil, yeni teknolojinin yarattığı karmaşayı azaltmaktan doğuyor.
Ama web çok hızlı büyüyordu. İnsanların bütün interneti kategorilere ayırması bir noktadan sonra yetmeyecekti. Artık bir haritadan fazlasına, bir arama kutusuna ihtiyaç vardı.
Bir kutuya birkaç kelime yazmak dünyayı değiştirdi
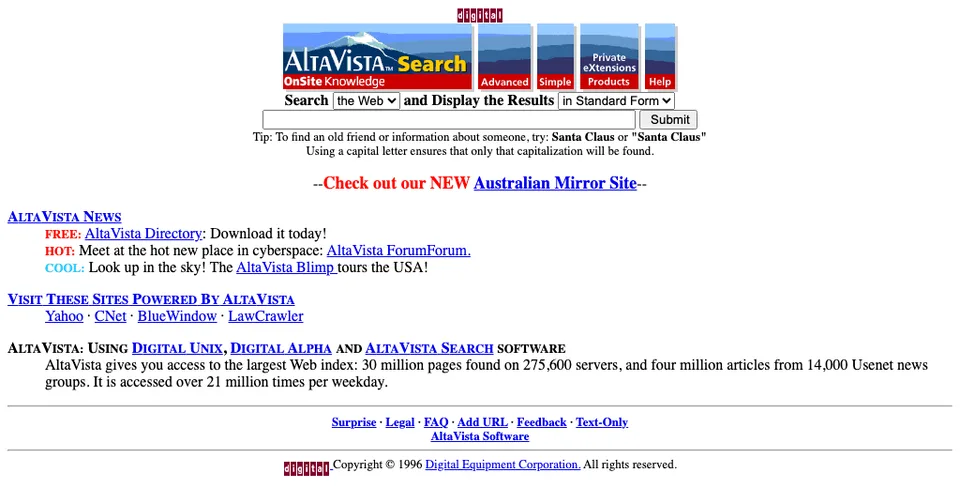
Digital Equipment Corporation laboratuvarlarında geliştirilen AltaVista 15 Aralık 1995'te halka açıldığında, dönemi için olağanüstü ölçekte web sayfasını tarayıp tam metin araması yapılabilir hale getiriyordu. Bugün son derece sıradan görünen hareketi düşünün: Bir kutuya kelime yazıyorsunuz, Enter'a basıyorsunuz ve makine sizin için internetin içinde arıyor. Bu çok büyük bir davranış değişikliğiydi. Yahoo “Nereye gitmek istiyorsun?” diye soruyordu; AltaVista ise “Ne arıyorsun?” İlkinde kullanıcı bir yapının içinde geziniyordu. İkincisinde niyetini söylüyor, makine uygun yerleri bulmaya çalışıyordu.
Tam bu dönemde bazı okurların hatırlayacağı başka bir isim hayata girdi: Copernic. Arkasındaki şirket 1996'da Kanada'da kuruldu; Copernic 98 ve ardından Copernic 99 gibi masaüstü yazılımları tek bir arama motoruna güvenmek yerine çok sayıda arama servisine aynı anda sorgu gönderebiliyor, sonuçları bir araya getirip tekrarları ayıklayarak kullanıcının önüne koyabiliyordu. 1999'da dönemin teknoloji basını onu, farklı internet arama servislerini aynı anda kullanan güçlü bir masaüstü araştırma aracı olarak tanımlıyordu.
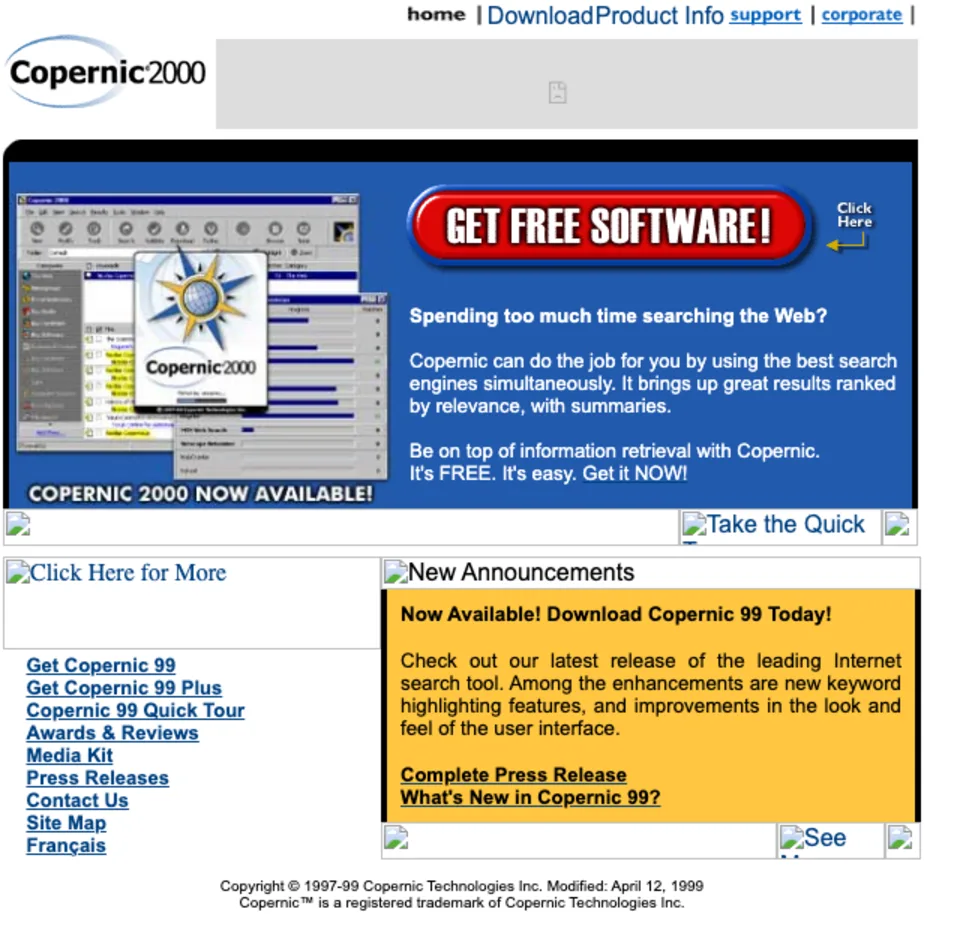
Burada hafızanın küçük bir oyunu var. Copernic çoğu zaman “Google'dan önce” diye hatırlanır; oysa kronoloji daha ilginç. Copernic'in şirket kökeni 1996'ya uzanırken Google, Stanford'daki araştırmanın ardından 1998'de şirketleşti. İki sistem aynı büyük sorunla boğuşan aynı dönemin farklı cevaplarıydı. Copernic “Birçok yere ben bakayım” diyordu; Google “Tek bir yerde daha iyi sonucu bulayım.” Bu ayrımı akılda tutmak gerekiyor, çünkü yazının sonunda Copernic'e geri döneceğiz. Hikayenin en güzel halkalarından biri orada kapanıyor.
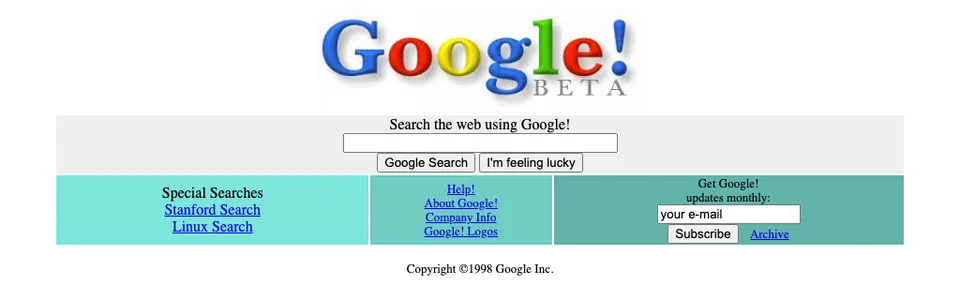
Önce Google'ın neyi değiştirdiğini hatırlamak gerekiyor. Web büyüdükçe problem artık yalnızca bir şeyleri bulmak değil, en doğru sonucu öne getirmekti. Stanford'da Larry Page ve Sergey Brin'in geliştirdiği PageRank yaklaşımı, web sayfaları arasındaki bağlantıları önem sinyallerinden biri olarak kullanıyordu. Google'ın o sade sayfasını hatırlayanlar bilir: Ekranın ortasında bir logo, altında bir kutu. Bugünkü internetin bütün gürültüsüyle karşılaştırınca neredeyse boş görünüyordu. Ama o boş kutunun arkasında devasa bir fikir vardı: İnternetteki bilgiyi düzenlemek.
Burada sadece arama teknolojisi değişmedi; yeni bir ekonomi doğdu. İnternette bir web sitesine sahip olmak artık yeterli değildi, bulunmak gerekiyordu. Arama motoru optimizasyonu (SEO), arama reklamcılığı, anahtar kelime analizi, performans pazarlaması, web analitiği: Bugün son derece olağan bulduğumuz işler zamanla bu yeni davranışın çevresinde oluştu. Küçük bir düşünce deneyi: 1997'de bir üniversite öğrencisine “Büyüdüğünde şirketlerin Google'da üst sıralara çıkmasını sağlayarak para kazanabilirsin” deseydiniz, önce Google'ın, sonra SEO'nun ne olduğunu açıklamanız gerekirdi. Çünkü meslek henüz ortada yoktu. Bu ayrıntı, birazdan bugünün yapay zeka tartışmalarına döndüğümüzde önemli olacak.
Sonra internette birbirimizi bulduk
Arama motorunda bilgi bulmak etkileyiciydi. Fakat ekranın diğer tarafında bir insanın olması başka bir şeydi. mIRC'ın ilk kamuya açık sürümü 28 Şubat 1995'te yayımlandı. Yazılımın geliştiricisi Khaled Mardam-Bey, o dönemdeki IRC istemcilerini zor veya sınırlı bulduğu için daha kolay ve keyifli kullanılabilecek bir istemci geliştirmeye başladığını anlatıyor. Bu küçük ayrıntı teknoloji tarihinin tekrar tekrar karşımıza çıkan kurallarından birini gösteriyor: Çoğu büyük ürün sıfırdan yepyeni bir insan ihtiyacı yaratmıyor, var olan bir şeyi daha az zahmetli hale getiriyor. IRC zaten vardı; mIRC kullanmayı kolaylaştırdı.
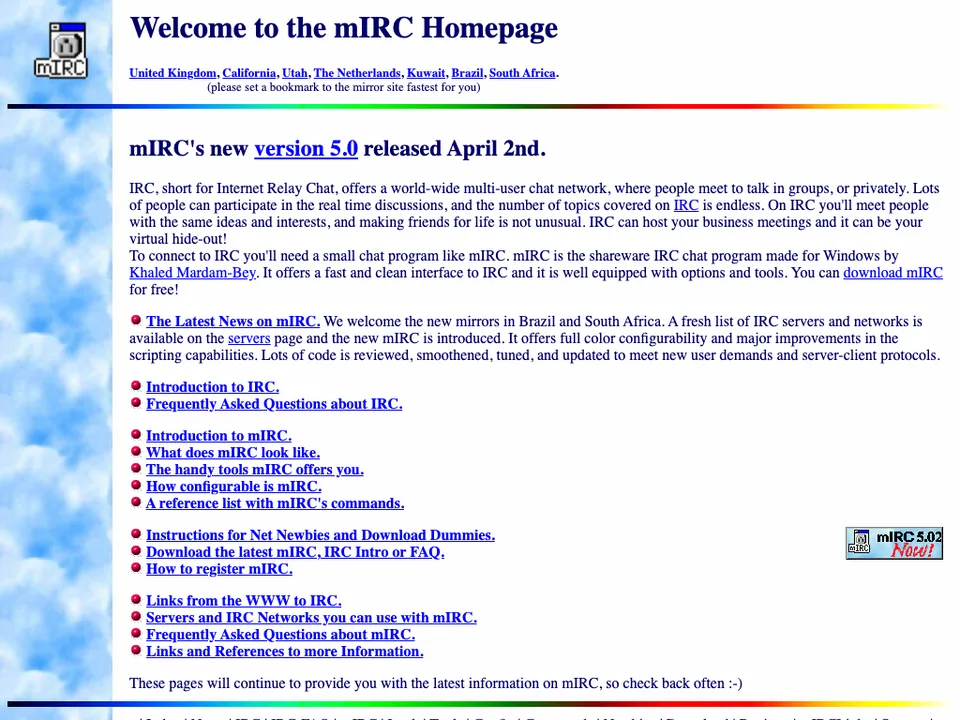
Bir kanala giriyordunuz. Ekranda kullanıcı adları, akan yazılar, bir “Selam.” Bugünün Instagram, TikTok ya da Discord dünyasıyla karşılaştırıldığında son derece ilkel görünebilir. Ama o ekranın yaşattığı hissi teknik özelliklerle açıklamak kolay değil: Dünyanın başka bir yerindeki, hayatınızda hiç karşılaşmadığınız biriyle o anda aynı dijital odadaydınız.
Bir süre sonra ICQ geldi. 1996'da İsrail'de geliştirilen ICQ, internet üzerinden anlık birebir iletişimi geniş kitlelerin gündelik kullanımına taşıyan öncü servislerden biri oldu. Öyle hızlı büyüdü ki geliştiricisi Mirabilis, Haziran 1998'de AOL tarafından yüz milyonlarca dolarlık bir anlaşmayla satın alındı. Dönemin AOL yöneticilerinden Bob Pittman'ın ICQ'yu tarif ederken yaptığı ayrım anlamlıydı: Bu, arama üzerine değil, başka bir insanla iletişim üzerine kurulmuş bir internet kapısıydı. İnternetin temel sorusu bir kez daha değişmişti: “Kim çevrimiçi?”
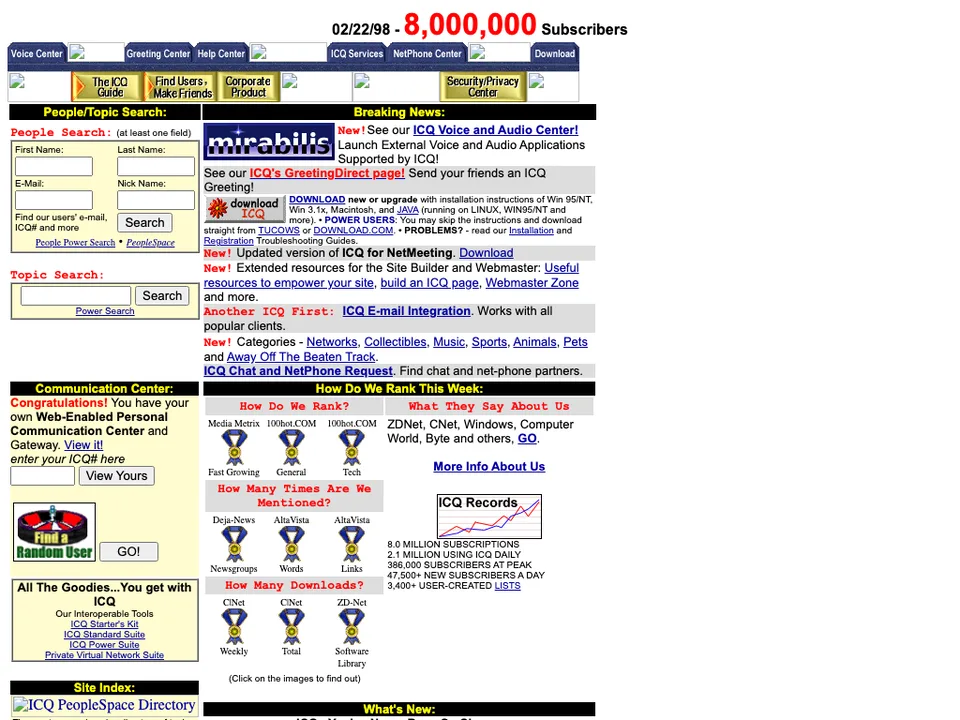
O dönemi yaşayanlar hatırlar: Çevrimiçi olmak görünür bir durumdu. Birisi internete bağlanır, listede belirir, sohbet başlardı. Bugün internet bağlantısının sürekli açık olması kadar doğal görünen bir davranış, o yıllarda başlı başına yeni bir deneyimdi. Ve yine fırsatlar ortaya çıktı: Dünyanın farklı yerlerinden topluluklar kurulabiliyor, teknik bilgi hızla paylaşılıyor, oyun toplulukları oluşuyor, uzaktaki insanların birlikte çalışmasının kültürel zemini kuruluyordu.
Fakat ilk defa başka sorunları da konuşmaya başladık: Anonimlik, çevrimiçi güven, kimlik, mahremiyet, taciz, çocukların internet ortamında korunması. Teknoloji yeni bir oda açmıştı ama o odada nasıl yaşanacağı henüz bilinmiyordu. Bu durum bugünkü yapay zeka tartışmalarını hatırlatıyorsa tesadüf değil. Teknoloji çoğu zaman önce gelir; toplumsal kurallar, hukuk, etik ve eğitim onun arkasından yetişmeye çalışır.
İnternet artık baktığımız değil, içinde yaşadığımız bir yerdi
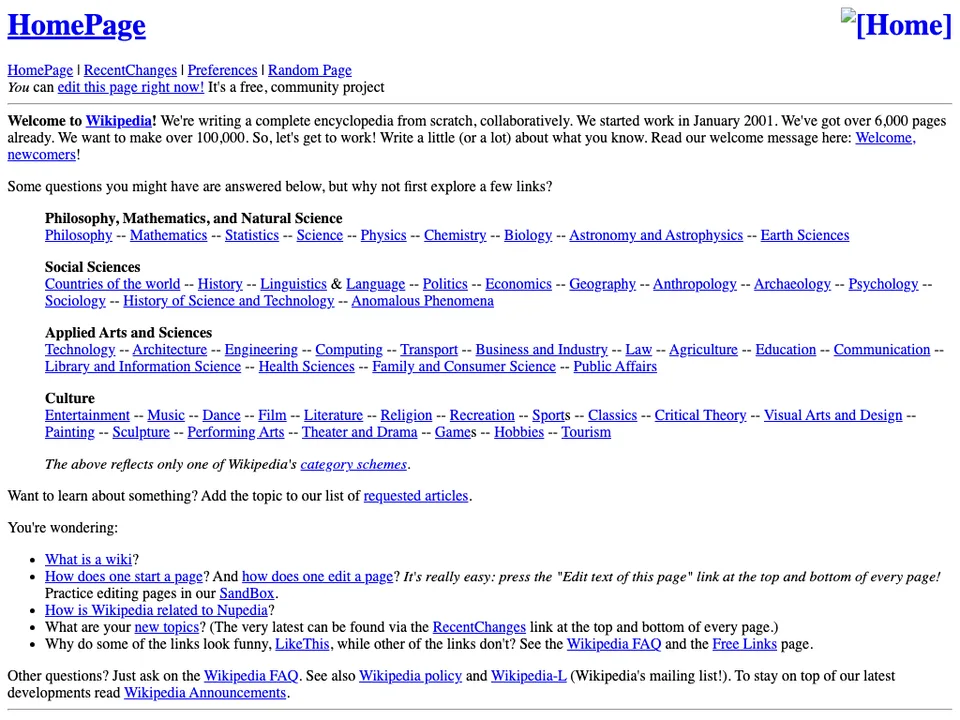
2000'lerin başında kullanıcı yalnızca web sayfalarına bakmıyor, web'i kendisi de oluşturmaya başlıyordu. Wikipedia 15 Ocak 2001'de yayın hayatına başladı. 2026'da 25. yılını geride bırakan yapı, yüz binlerce gönüllünün birlikte oluşturduğu, 300'den fazla dilde 65 milyon maddeye ulaşan küresel bir bilgi altyapısına dönüştü. O gün için düşünce radikaldi: Ansiklopedi dediğiniz şey uzmanlar tarafından hazırlanır, basılır, ciltlenir ve kitaplıkta dururdu. Şimdi dünyanın farklı yerlerinden insanlar aynı bilgi kaynağını birlikte oluşturabiliyordu. Tüketici ile üretici arasındaki çizgi bulanıklaşmaya başlamıştı.
Hemen ardından internet başka bir soru sormaya başladı: “Peki sen kimsin?” LinkedIn 5 Mayıs 2003'te yayına açıldı; ilk ayının sonunda 4.500 üyesi vardı. Yıllar içinde profesyonel profil, bağlantı, iş ilanı ve işe alım altyapısıyla iş hayatının dijital katmanlarından birine dönüştü. 2004'te Harvard'da The Facebook ortaya çıktı; başlangıçta üniversite öğrencilerine yönelik çevrimiçi bir sosyal dizindi, Eylül 2006'da geçerli bir e-posta adresi olan herkese açıldı.
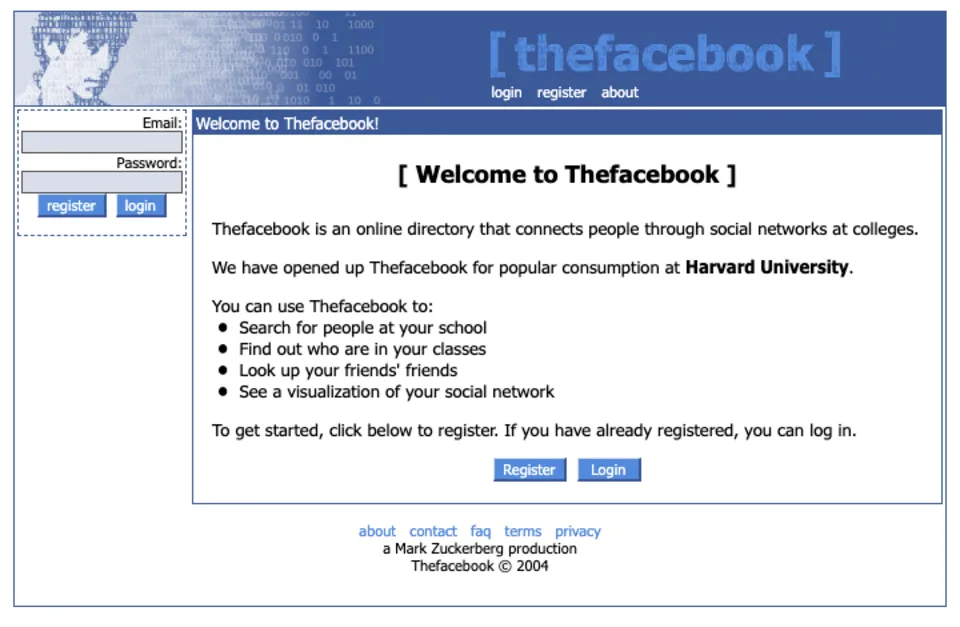
Burada çok önemli bir eşik geçildi. İnternette artık yalnızca bilgi aranmıyor, insanlar kendilerini de inşa ediyordu: Fotoğraflar, arkadaşlar, eğitim, iş, ilgi alanları, bağlantılar, profesyonel geçmiş. Dijital dünya yavaş yavaş fiziksel hayatın bir temsiline dönüşmeye başladı. Bir kez daha, bugün son derece normal görülen koca sektörler ortaya çıktı: Profesyonel ağ kurma, çevrimiçi işe alım, kişisel marka, sosyal medya yönetimi, topluluk yönetimi, sosyal satış, dijital itibar. Bunların hiçbiri web'in ilk yıllarında bugünkü anlamıyla yerleşik kariyer alanları değildi.
Fakat fırsatın yanında bedeli de geldi. Kendimizi internete taşıdıkça iz bırakmaya başladık. Daha önce arkadaş ortamında söylenip unutulan bir söz artık yıllarca bulunabilir hale geliyor, eski bir fotoğraf kaybolmuyor, iş hayatıyla özel hayat arasındaki sınırlar bulanıklaşıyordu. Dijital kimlik fırsat yaratırken dijital ayak izi de yaratıyordu.
Hepimiz yayıncı olduğumuzda dünya başka bir yere döndü
23 Nisan 2005. San Diego Hayvanat Bahçesi. Kameranın karşısında genç bir adam, arkasında filler. Yaklaşık 19 saniyelik son derece sıradan bir görüntü: YouTube'a yüklenen ilk video, “Me at the zoo.” Bugünden bakınca dünyanın en büyük medya dönüşümlerinden birinin başlangıcının bu kadar sıradan olması neredeyse şiirsel geliyor.
YouTube'un devrimi internette video olması değildi; video zaten vardı. Asıl devrim şuydu: Yayın yapabilmek için artık bir televizyon kanalına ihtiyacınız yoktu. Bir dönem kitlelere video ulaştırmak son derece pahalı bir işti: Stüdyo, dağıtım, frekans, yayıncı gerekiyordu. YouTube bu yapının önemli bir bölümündeki sürtünmeyi ortadan kaldırdı. Bir kamera, bir internet bağlantısı, bir fikir; teorik olarak bütün dünya karşınızdaydı. Ekonomik sonuç birkaç yıl içinde belirginleşti: YouTube 2007'de kullanıcı üreticilerini reklam gelirinden pay alabilecekleri Partner Program'a dahil etmeye başladı. Bugün “creator economy” dediğimiz içerik üreticisi ekonomisinin büyük bölümünün o gün henüz adı yoktu.
Eğitim açısından daha da ilginç bir hikaye vardı. 2004'te Boston'da yaşayan Salman Khan, New Orleans'taki kuzenine matematik anlatmaya başladı; telefon ve Yahoo'nun Doodle aracını kullanıyordu. Öğrenci sayısı artınca zamanlama zorlaştı ve 2006'da derslerini YouTube'a yüklemeye başladı. İnsanlar videoları kendi hızlarında izleyebiliyordu. Bu süreç 2008'de kâr amacı gütmeyen Khan Academy'nin kuruluşuna uzandı.
Burada dijital eğitimin geleceğine dair çok önemli bir fikir vardı: Öğrenme, öğretmenin takviminden ayrılabiliyordu. Öğrenci videoyu durdurabiliyor, geri alabiliyor, bir daha izleyebiliyor, gece çalışabiliyor, başka bir ülkedeki öğretmenden öğrenebiliyordu. Bir öğretmen aynı anlatımı tekrar tekrar yapmak yerine bir kere kaydedip milyonlarca insana ulaştırabiliyordu. İçeriğin dağıtım maliyeti dramatik biçimde düşüyordu. Ama yıllar sonra başka bir gerçek de öğrenildi: İçeriğin ölçeklenmesi, öğrenmenin otomatik olarak ölçeklendiği anlamına gelmiyordu. Bir videonun milyonlarca kişiye ulaşabilmesi başka şeydi, milyonlarca kişinin gerçekten öğrenmesi başka. Bu ayrım bugün yapay zeka döneminde yeniden karşımızda.
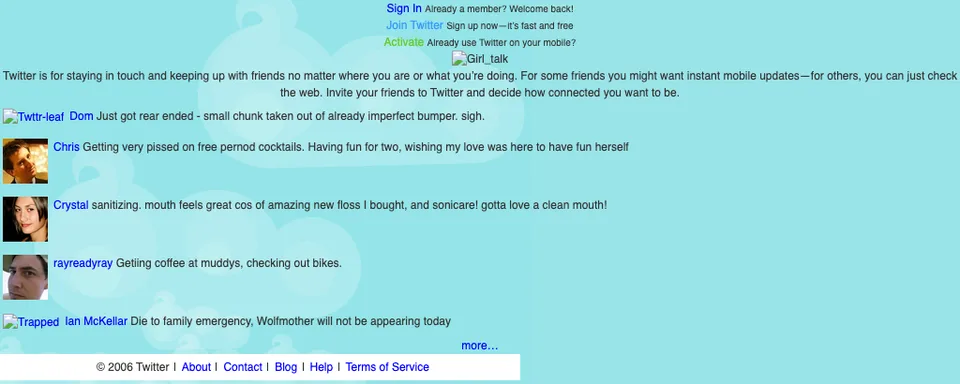
2006'da başka bir küçük fikir ortaya çıktı: Kısa metinler ve tek bir soru, “Şu anda ne yapıyorsun?” İlk yıllarında “twttr” adıyla başlayan servis zamanla Twitter'a, sonra X'e dönüştü. Twitter'ın büyük etkilerinden biri interneti gerçek zamanlı bir kamusal alana çevirmesiydi. Bir deprem, bir futbol karşılaşması, bir ürün lansmanı: Dünyanın herhangi bir yerindeki olay hakkında birkaç saniye içinde milyonlarca insan aynı dijital ortamda konuşabiliyordu. Eskiden gazete ertesi sabah alınırdı; şimdi olay olurken olayın içindeki insanların anlattıkları okunuyordu. Fakat aynı denklem çalıştı: Hız arttıkça doğrulama süresi azaldı. Herkes yayıncı olabiliyordu, ama herkes editör değildi.
Sonra internet bize “Sen arama, ben seçerim” dedi
İnternet tarihindeki en büyük kırılmalardan biri belki de yeterince dramatik görünmediği için gözden kaçtı. Bir sabah internetin çalışma şekli değişmişti: Artık sürekli aramak zorunda değildik. Akış vardı. Facebook 2006'da News Feed'i devreye aldığında kullanıcı tepkisi o kadar büyüktü ki şirket birkaç gün içinde ek gizlilik kontrolleri açıklamak zorunda kaldı. Ama geri dönüş yoktu. İnternet artık yalnızca istediğimizi göstermiyor, ne görmek isteyebileceğimizi tahmin etmeye başlıyordu. Arama motorunda kullanıcı başlangıç noktasını belirler: “Bana İstanbul'daki müzeleri göster.” Akışta ise sistem başlangıç noktasını seçebilir: “Bunu da sevebilirsin.” Bilgiye ulaşma sorumluluğunun bir bölümü kullanıcıdan algoritmaya geçmişti.
Kişiselleştirme sosyal medyayla başlamadı. Amazon'un 2003'te IEEE Internet Computing'de yayımlanan teknik çalışması, satın alınan ve değerlendirilen ürünlerden hareketle gerçek zamanlı kişiselleştirilmiş öneriler üreten sistemini ayrıntılı biçimde anlatıyordu. Netflix ise 2006'da öneri sistemini geliştirmek için bir milyon dolarlık Netflix Prize yarışmasını başlattı. Sonra bu mantık sosyal medyanın merkezine yerleşti: YouTube, Instagram, TikTok, Spotify, Netflix. TikTok kendi yardım sayfasında For You akışını, kullanıcının ilgi alanları ve etkileşimlerinden hareketle kişiselleştirilen bir içerik akışı olarak tanımlıyor.
Burada çok ilginç bir şey oldu: Hepimizin kullandığı internet aynıydı ama gördüğümüz internet aynı değildi. İki kişinin YouTube ana sayfası farklı, aynı Spotify uygulamasında öneriler farklı, herkesin TikTok'u başka bir dünya. İnternet kişiselleşiyordu. Fırsat tarafı çok büyüktü: Milyonlarca içerik arasından ilgi çekeni bulmak kolaylaştı, küçük üreticilerin doğru kitleye ulaşma şansı arttı; performans pazarlaması, büyüme ekipleri, öneri sistemi mühendisliği, influencer pazarlaması, programatik reklamcılık, dönüşüm optimizasyonu gibi alanlar büyüdü.
Ama başka bir sorun belirdi. Bir önceki internet çağında kıt olan şey bilgiydi; bu çağda kıt kaynak giderek dikkat olmaya başladı. Platformlar yalnızca doğru şeyi bulmamıza yardım etmiyor, ekranda ne kadar kalacağımız için de rekabet ediyordu. Bu durum öğrenme dünyasını da değiştirdi: Bir eğitim içeriği artık yalnızca başka eğitim içerikleriyle değil, aynı telefon ekranındaki Netflix'le, YouTube'la, TikTok'la, oyunlarla, mesajlarla ve bildirimlerle rekabet ediyordu. Dijital eğitim tasarımının önüne yeni bir soru çıkmıştı: İçeriği dijitale aktarmak yetiyor mu, yoksa deneyimi de yeniden düşünmek mi gerekiyor?
İnternet cebimize girdiğinde görünmez olmaya başladı
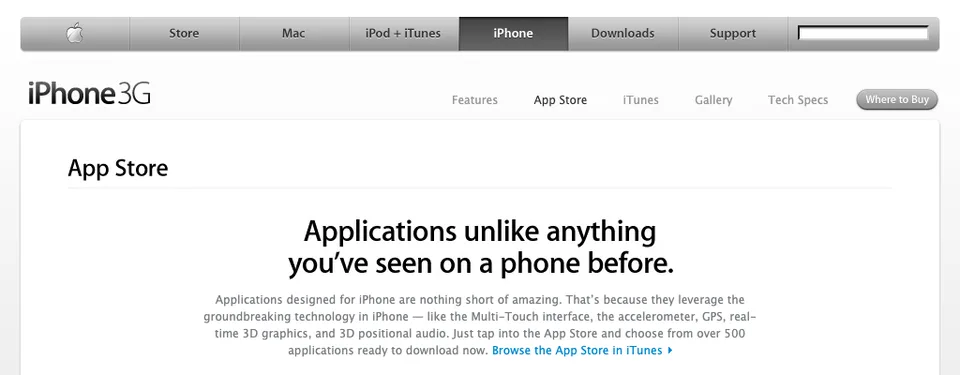
9 Ocak 2007'de Steve Jobs ilk iPhone'u tanıttığında cihazı üç ürünün birleşimi olarak tarif etmişti: Telefon, geniş ekranlı iPod ve internet iletişim cihazı. Asıl ekonomik kırılma bir yıl sonra geldi. App Store 10 Temmuz 2008'de 500 uygulamayla açıldı; ilk hafta sonunda on milyondan fazla uygulama indirilmişti.
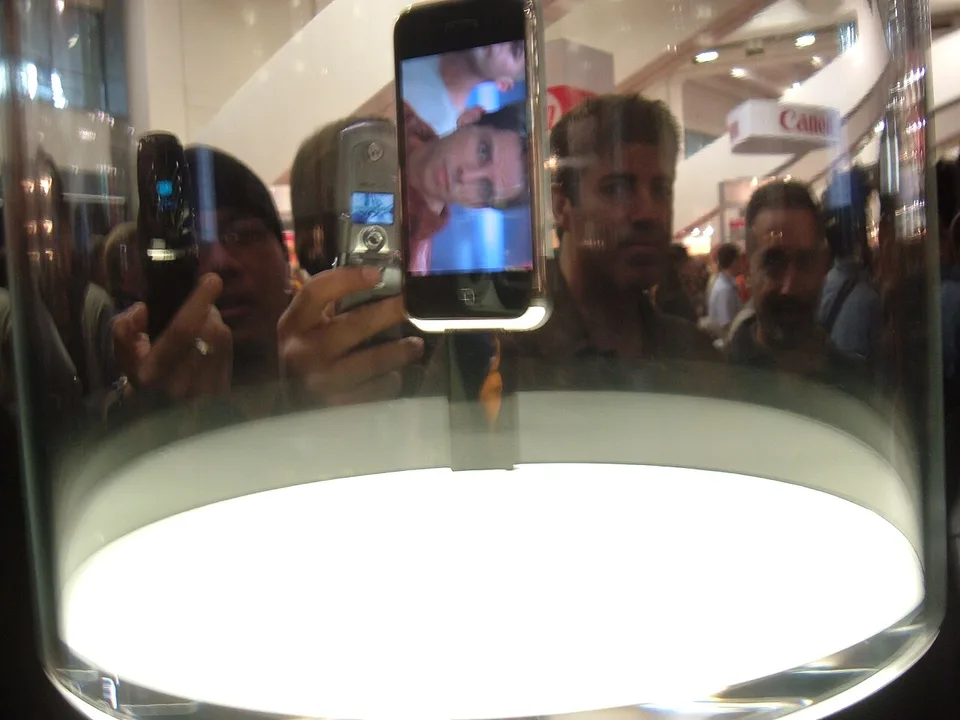
O ana 2008'in gözleriyle bakalım. Yazılım dağıtmak eskiden ciddi bir operasyondu: Program yazılır, insanların onu bulması, satın alması, indirmesi ya da fiziksel olarak edinmesi, kurması gerekirdi; güncellemeler ayrı bir meseleydi. App Store bunun önemli bir bölümünü tek bir dağıtım katmanında topladı. Birdenbire birkaç kişilik bir ekip dünyanın çok farklı ülkelerindeki insanlara yazılım ulaştırabilir hale geldi. Mobil oyunlar, fintech, yemek siparişi, ulaşım, sağlık uygulamaları, dil öğrenme uygulamaları: Yeni bir ekonomi oluştu.
Daha önemlisi, internet bir yere giderek kullandığımız bir şey olmaktan çıktı; bizimle dolaşmaya başladı. Eskiden “internete giriyorduk,” şimdi cebimizde internet vardı. Bu, öğrenmeyi de mekândan kopardı. Bir eğitim için bilgisayar başına geçmek gerekmiyordu: Otobüste, metroda, evde, iş yerinde, beş dakikalık boşlukta. Öğrenme davranışı küçük parçalara ayrılabilir hale geldi. Mikro öğrenmenin, mobil öğrenmenin ve “ihtiyaç anında öğrenme” yaklaşımlarının yükselmesinin arkasında yalnızca pedagojik fikirler değil, insanın dijital hayatının değişmesi de vardı. Teknoloji davranışı değiştiriyor, davranış eğitim tasarımını değişmeye zorluyordu.
Sonra karşımıza boş bir sohbet kutusu çıktı
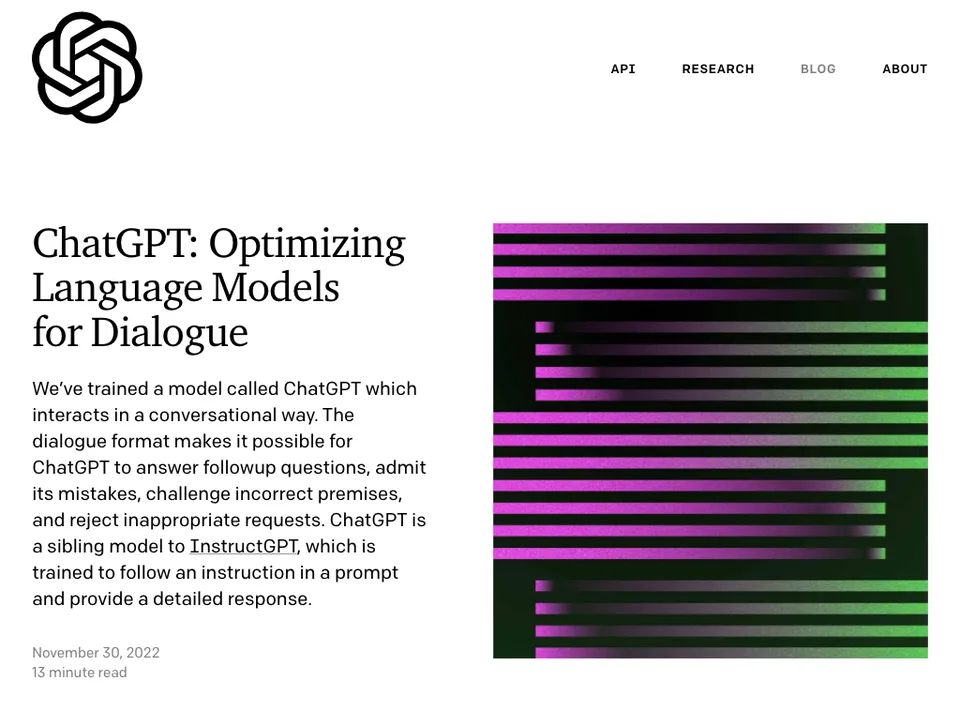
30 Kasım 2022. İnternette yeni bir sayfa açıldı. İlk bakışta çok etkileyici görünmeyebilirdi: Bir sohbet alanı, altında yazı yazılabilecek bir kutu. ChatGPT araştırma ön izlemesi olarak kullanıma sunulduğunda öne çıkan fikirlerden biri, sistemle diyalog kurulabilmesi ve takip sorularının konuşma bağlamında sürdürülebilmesiydi.
İlk günlerde insanların yaptığı şeyleri hatırlayın: “Bana şiir yaz.” “Bu kod neden çalışmıyor?” “Bir e-posta hazırla.” “Bu metni özetle.” Bazen eğlenceliydi, bazen şaşırtıcı, bazen yanlış cevap veriyordu. Çoğu kişi için başlangıçta gelişmiş bir sohbet botu gibi görünüyordu. Ama arka planda internet kullanımında çok daha temel bir değişiklik başlıyordu.
Google çağında bir sorunun yolculuğu kabaca şöyleydi:
Arama çağında bir sorunun yolculuğu
- Soruyu yaz.
- Sonuçlara bak.
- Bir bağlantıya tıkla.
- Başka bağlantıya git.
- Metinleri oku.
- Karşılaştır.
- Not al.
- Sonucu kendin oluştur.
Üretken yapay zeka bu zincirin ortasına girdi. Şimdi kullanıcı “Roma'daki müzeleri bul” yerine “Roma'da üç günüm var, sanatla ilgileniyorum, çok turistik olmayan iki restoran da olsun, bana program hazırla” diyebiliyordu. “Liderlik hakkında kaynak bul” yerine “Bu araştırmaları incele, ortak noktalarını çıkar ve yeni yöneticiler için bir eğitim akışı tasarla.” Bir başka ifadeyle, internette bilgi bulmak ile o bilgiden bir sonuç üretmek arasındaki mesafe kısalmaya başladı. Arama motoru kaynak getiriyordu; üretken yapay zeka taslak bir sonuç getirebiliyordu.
Bu son derece güçlüydü ama aynı zamanda internet çağının yeni problemini doğurdu. Arama motorunda yanlış bir siteye tıklayabilirsiniz. Yapay zeka ise yanlış bilgiyi son derece düzgün cümlelerle, gayet emin görünen bir yanıt halinde sunabilir. Ortaya ilginç bir paradoks çıktı.
Bilgiye ulaşmak hiç bu kadar kolay olmamıştı. Bilginin doğruluğunu değerlendirebilmek de hiç bu kadar önemli olmamıştı.
Ve şimdi yapay zeka bizi tanımaya başlıyor
Bugün yaşanan asıl dönüşüm belki ChatGPT'nin 2022'de açılması bile değil. Sohbet kutusu yalnızca ilk aşamaydı. 2025 ve 2026 boyunca yapay zeka sistemleri iki yönde hızla ilerledi: Bizi daha iyi tanımak ve bizim için daha fazla şey yapabilmek.
Kişiselleştirme bunun ilk tarafı. Güncel sistemlerde kullanıcı izin verdiğinde geçmiş konuşmalar, tercihler, projeler, dosyalar ve bağlı kaynaklardan gelen bağlam yeni konuşmalarda kullanılabiliyor. OpenAI Haziran 2026'da bellek sistemini, tercihleri, projeleri ve kısıtları zaman içinde sentezleyerek konuşmaların her seferinde sıfırdan başlamamasını sağlayan bir yapı olarak yeniledi. Google da Gemini için Gmail, Fotoğraflar, YouTube ve Arama gibi servislerden gelen, kullanıcının kontrolündeki bağlamı bir araya getiren “Kişisel Zeka” özelliğini Nisan 2026'da Türkiye'de kullanıma sundu.
Bir düşünün. Otuz yılda internetin kullanıcıya sorduğu soru beş kez değişti:
İnternetin sorusu nasıl değişti
- Yahoo: “Nereye gitmek istiyorsun?”
- Google: “Ne arıyorsun?”
- Sosyal medya: “Nelerden hoşlanıyorsun?”
- Öneri algoritması: “Ne isteyebileceğini tahmin edebilirim.”
- Kişiselleştirilmiş yapay zeka: “Seni ve bağlamını tanıdığıma göre nasıl yardımcı olabilirim?”
Bu yalnızca daha iyi tavsiye demek değil; arayüzün kendisi değişiyor. Aynı soruyu iki kişi soruyor ama geçmişleri, hedefleri, işleri ve ihtiyaçları farklıysa ideal yanıtın da farklı olması bekleniyor.
Bir sonraki dönüşüm daha da büyük: Cevap üretmekten iş yapmaya geçiş. 2025'te kullanıma sunulan yapay zeka ajanı sistemleri web'de araştırma yapma, dosyaları inceleme, formlarla ve elektronik tablolarla çalışma gibi çok adımlı görevleri gerçekleştirmeye başladı. 2026'da bu yaklaşım, daha uzun süreli işleri araştırıp analiz ederek tamamlanmış belge, tablo, sunum ya da başka çıktılara dönüştürebilen çalışma sistemlerine evrildi. Burada çok büyük bir fiil değişikliği var.
Üç dönem, üç fiil
- Önce: “Bana göster.”
- Sonra: “Bana anlat.”
- Şimdi, giderek: “Benim için yap.”
Ve işte Copernic yeniden karşımızda
Tam burada otuz yıl geriye dönüp Copernic'e tekrar bakalım. 1999'da Copernic'in temel vaadini hatırlayın: Kullanıcının tek tek farklı arama motorlarına gitmesi gerekmiyordu. Bir sorgu veriyordunuz; yazılım çeşitli kaynaklara gidiyor, sonuçları topluyor ve önünüze getiriyordu.
Yaklaşık otuz yıl sonra bugün gelişmekte olan yapay zeka sistemlerine bakın. Web, dosyalar, e-postalar, takvim, kurumsal uygulamalar, veritabanları, bağlı servisler. Kullanıcı tek tek hepsinin içinde dolaşmak yerine hedefini söylüyor. Sistem uygun kaynaklara gidiyor, bilgiyi topluyor, karşılaştırıyor, işliyor ve giderek bir sonuç üretmekle kalmayıp sonraki adımları da gerçekleştirebiliyor. Elbette iki teknoloji arasında muazzam bir kapasite farkı var; ama fikir düzeyinde ilginç bir akrabalık var.
Aynı fikir, otuz yıl arayla
- Copernic, 1999: “On yere sen gitme, ben gidip sonuçları getireyim.”
- Yapay zeka ajanı, 2026: “Araştırmayı da, bazı işlemleri de tek tek sen yapma, bana hedefini söyle.”
Teknoloji tarihinin güzel taraflarından biri bu: Bazı fikirler gerçekten kaybolmuyor, teknoloji yeterince geliştiğinde başka bir biçimde geri geliyor.
Aslında bütün hikaye tek bir şeyin etrafında dönüyor: Sürtünme
Buraya kadar anlatılan otuz yılı bir an için teknoloji isimlerinden arındıralım. Yahoo'yu, Google'ı, Facebook'u, YouTube'u, iPhone'u, ChatGPT'yi unutalım. Geriye daha basit bir hikaye kalıyor: Her dönemde insanın yapmak istediği bir şey vardı, ama önünde bir sürtünme bulunuyordu.
| Dönem | Kullanıcının sorusu | Kalkan sürtünme | Doğan fırsat | Doğan problem |
|---|---|---|---|---|
| Dizin (Yahoo, 1994) | Nereye gideceğim? | Web'de kaybolmak | Kürasyon | Elle sınıflama ölçeklenmedi |
| Arama (AltaVista, Google, 1995-1998) | Ne arıyorum? | Bilgiyi bulma ve sıralama | SEO, arama reklamcılığı, web analitiği | Görünürlük rekabeti, bilgi kalitesi |
| Mesajlaşma (mIRC, ICQ, 1995-1996) | Kim çevrimiçi? | Mesafe | Çevrimiçi topluluklar, uzaktan iş birliği | Anonimlik, güven, taciz, çocuk güvenliği |
| Dijital kimlik (LinkedIn, Facebook, 2003-2004) | Ben kimim, kimi tanıyorum? | Profesyonel ve sosyal çevreyi taşıma | İşe alım, kişisel marka, sosyal medya yönetimi | Dijital ayak izi, mahremiyet |
| Yayıncılık (YouTube, Twitter, 2005-2006) | Ben de yayın yapabilir miyim? | Dağıtım maliyeti | İçerik üreticisi ekonomisi, Khan Academy modeli | Yanlış bilgi, doğrulama süresi |
| Akış ve öneri (News Feed, Netflix Prize, 2006) | Hangisine bakmalıyım? | Seçim yükü | Performans pazarlaması, öneri mühendisliği | Dikkat ekonomisi |
| Mobil (iPhone, App Store, 2007-2008) | Neden masa başında olmak zorundayım? | Yazılım dağıtımı, mekân bağımlılığı | Uygulama ekonomisi, mikro öğrenme | Platform bağımlılığı |
| Üretken yapay zeka (ChatGPT, 2022) | Bunları tek tek okumaya zamanım yok | Bilgiden sonuca giden zincir | Üretim ve araştırma hızı | Doğrulama, telif, güven, veri mahremiyeti |
| Kişisel yapay zeka ve ajanlar (2025-2026) | Neden on uygulamada on adımı ben yapıyorum? | Koordinasyon maliyeti | Henüz adı konmamış işler | Hangi karar makineye devredilir? |
Dijital dönüşümün tarihine bu gözle bakıldığında girişimcilik açısından da değerli bir ders çıkıyor.
Büyük fırsatın bulunduğu yer bazen yeni teknolojinin kendisi değil, insanların hâlâ katlanmak zorunda olduğu gereksiz sürtünmedir.
Ama her sürtünme ortadan kalktığında yeni bir problem doğuyor
Teknoloji tarihini romantikleştirmemek gerekiyor, çünkü hikaye yalnızca “her şey sürekli daha iyi oldu” şeklinde ilerlemedi. Yahoo ve arama motorları bilgiye erişimi kolaylaştırdı ama bilgi kalitesi problemi büyüdü. Sosyal medya herkese yayın yapma imkânı verdi ama yanlış bilgi, manipülasyon ve dijital taciz daha görünür hale geldi. Öneri sistemleri milyonlarca seçenek arasından seçim yapmayı kolaylaştırdı ama dikkat ekonomisini büyüttü. Mobil uygulamalar küçük ekiplerin önünü açtı ama işletmelerin büyük platformların kurallarına bağımlılığını artırdı. Üretken yapay zeka üretme ve araştırma hızını yükseltti ama doğrulama, telif, güven ve veri mahremiyeti gibi sorunları daha önemli hale getirdi. Kişiselleştirilmiş yapay zeka daha alakalı yanıtlar üretebilir ama sistemin sizi ne kadar tanımasını istediğiniz sorusunu beraberinde getiriyor. Ajanlar günlük işleri kolaylaştırabilir ama başka bir soru yaratıyor: Hangi kararı makineye devredebiliriz, hangisini devretmemeliyiz?
Teknoloji tarihinde belki de en tutarlı desen bu: Bir dönemin çözümü, çoğu zaman bir sonraki dönemin problemini yaratıyor. Ve yeni fırsatlar da genellikle tam o problemlerin çevresinde doğuyor. Arama motoru çıktı, SEO doğdu. E-posta büyüdü, spam filtreleri doğdu. E-ticaret büyüdü, çevrimiçi ödeme ve güvenlik sistemleri gelişti. Sosyal medya büyüdü; içerik moderasyonu, sosyal medya analitiği ve dijital itibar alanları doğdu. Yapay zeka büyüdükçe de bugün küçük görülen doğrulama, güven, kimlik, veri kontrolü, yapay zeka güvenliği ve insan ile yapay zeka arasındaki iş akışı gibi alanların bazılarının yepyeni endüstrilere dönüştüğü görülecek.
Peki eğitim bu hikayenin neresinde?
Aslında başından beri tam ortasında. İnternetin her dönüşümü öğrenmenin bir özelliğini değiştirdi. Web bilgiyi dijitalleştirdi. Arama motorları bilgiyi bulunabilir hale getirdi. Wikipedia bilgiyi kolektif hale getirdi. YouTube anlatımı ölçekledi. Mobil cihazlar öğrenmeyi mekândan kopardı. Öğrenme yönetim sistemleri (LMS) süreci yönetilebilir ve izlenebilir hale getirdi. Öneri sistemleri içerik seçiminde kişiselleştirme beklentisini artırdı. Şimdi üretken yapay zekayla ilk kez içeriğin kendisi bizimle konuşabiliyor.
Bu, önceki eğitim teknolojisi dalgalarından farklı. Bir PDF size “Burayı anlamadığını düşünüyorum, başka örnekle anlatayım mı?” demez. Klasik bir video, verdiğiniz yanlış cevabın arkasındaki düşünceyi anlamaya çalışmaz. Önceden hazırlanmış bir quiz, sorunun cevabını bilmediğiniz için mi yoksa soruyu yanlış yorumladığınız için mi hata yaptığınızı doğal dil üzerinden tartışamaz. Yapay zeka bunu mümkün kılmaya başlıyor.
Ama burada çok kritik bir tehlike var.
Öğrenciye bir işi yaptırmak ile öğrencinin öğrenmesini sağlamak aynı şey değil.
OECD'nin Ocak 2026'da yayımladığı Digital Education Outlook 2026 raporu bu ayrım üzerinde özellikle duruyor. Rapor, genel amaçlı üretken yapay zeka kullanımının öğrencilerin ortaya çıkardıkları ürünün kalitesini yükseltebildiği durumlarda bile bunun otomatik olarak daha iyi öğrenme anlamına gelmediğini; pedagojik rehberlik olmadan görevin yapay zekaya devredilmesinin performansı artırıp gerçek öğrenme kazanımı sağlamadığını, öğrenme hedeflerine uygun tasarımın belirleyici olduğunu vurguluyor. Sitemizde yakın zamanda ele aldığımız “en iyi öğrenenler yapay zekayı daha kontrollü kullanıyor” bulgusu da aynı yöne işaret ediyor.
Bir öğrenci yapay zeka kullanarak mükemmel bir rapor hazırladıysa neyi ölçtük? Raporun kalitesini mi, öğrencinin bilgisini mi, yapay zeka kullanma becerisini mi, muhakemesini mi? Ve hepsinden önemlisi: Gerçekten öğrendi mi? Bu sorular eğitim tasarımının merkezine taşınacak. Çünkü yapay zekayla birlikte öğrenmenin önündeki bazı sürtünmeler ortadan kalkarken, öğrenmenin kendisini makineye devretme riski de ortaya çıkıyor. Dolayısıyla geleceğin iyi eğitim teknolojisi ürünü muhtemelen öğrenci adına mümkün olduğunca çok şey yapan ürün olmayacak; tam tersine, öğrencinin düşünmesini gerektiren doğru noktaları koruyan ürün olacak.
Yapay zeka okuryazarlığını “iyi prompt yazmak” sanırsak önemli kısmı kaçırırız
Bugün birçok yapay zeka eğitiminin merkezinde hâlâ prompt yazmak bulunuyor: “Rol verin, bağlam ekleyin, çıktı formatını belirtin.” Bunların faydası var. Ama muhtemelen bugünkü komut satırını öğrenmek gibi geçici bir katmana fazla önem veriliyor. Arayüzler geliştikçe sistemler zaten eksik bağlamı kullanıcıdan isteyecek, niyeti daha iyi anlayacak, daha uzun projeleri takip edecek.
Kalıcı beceri başka bir yerde. Aşağıdaki sorular bir kontrol listesi olarak okunabilir; bir kurum yapay zeka eğitimi tasarlarken müfredatın bu soruların kaçına cevap verdiğine bakabilir:
- Problemi tanımlayabiliyor muyum?
- Hangi kısmı makineye vereceğimi, hangi kısmı kendim yapmam gerektiğini biliyor muyum?
- Sonucun mantıklı olup olmadığını değerlendirebiliyor muyum?
- Kaynağın nereden geldiğini sorguluyor muyum?
- Yanlış bir cevabı ve önyargıyı fark edebiliyor muyum?
- Kişisel ya da kurumsal verinin sınırını biliyor muyum?
- Kendi fikrimle yapay zekanın fikrini birbirinden ayırabiliyor muyum?
- Çıktı ile bilgi arasındaki farkı anlayabiliyor muyum?
OECD ve Avrupa Komisyonu tarafından 2026'da yayımlanan AI Literacy Framework de yapay zeka okuryazarlığını yalnızca araç kullanımı olarak tanımlamıyor; yapay zeka sistemlerini anlama, çıktılarını eleştirel biçimde değerlendirme ve teknolojiyi etik ve yaratıcı biçimde kullanabilme gibi bilgi, beceri ve tutumları birlikte ele alıyor. Öğretmenler için hazırladığımız yapay zeka okuryazarlığı rehberi bu çerçeveyi sınıf pratiğine çevirmeyi deniyor. Bu nedenle geleceğin “yapay zeka konusunda iyi” insanı belki en fazla yapay zeka kullanan kişi olmayacak; neyi yapay zekaya vermesi gerektiğini ve neyi vermemesi gerektiğini bilen kişi olacak. Bu eğitim dünyası için küçük bir müfredat güncellemesi değil, oldukça büyük bir zihniyet değişimi.
Ya eğitim içeriği de artık herkese aynı olmak zorunda değilse?
Bugüne kadar normal kabul edilen bir şeyi sorgulayalım. Netflix'i açan herkes aynı ana sayfayı görmüyor. Spotify herkese aynı müziği önermiyor. TikTok herkese aynı akışı göstermiyor. Yapay zeka sistemleri giderek kullanıcının geçmişini, tercihlerini ve bağlamını anlayabiliyor. Ama eğitimde hâlâ sıklıkla şu yapılıyor: Yüzlerce çalışana aynı modül, aynı sırayla, aynı örneklerle, aynı sorularla, aynı sürede.
Belki önümüzdeki eğitim teknolojisi kırılması burada gerçekleşecek. Aynı satış eğitiminin herkese gösterilmesi yerine, çalışanın zorlandığı müşteri tipine göre değişen simülasyonlar. Yeni yöneticinin verdiği kararlara göre dallanan bir liderlik deneyimi. Bir çalışanın doğal dilde konuştuğu sanal müşteri. Oryantasyonda çalışanın görevine göre farklı bir yol. Bir güvenlik eğitiminde yalnızca “doğru seçeneği” değil, kişinin neden o kararı verdiğini değerlendiren sistem. Öğrenenin hatasına göre anında yeni örnek oluşturan içerik. Kişiselleştirilmiş öğrenme üzerine daha önce yazdıklarımız bu listenin teknik zeminini anlatıyor.
Burada dijital eğitim, yalnızca önceden hazırlanmış içeriği oynatan bir sistem olmaktan uzaklaşıp içeriği, deneyimi ve geri bildirimi o anda üreten bir sisteme dönüşebilir. Ancak yine aynı şart geçerli: Amaç yapay zeka göstermek değil, öğrenmeyi iyileştirmek. Bu ayrımı koruyanlar ile yalnızca yeni teknoloji ekleyenler arasındaki fark önümüzdeki yıllarda çok daha görünür hale gelecek.
“Yapay zeka işlerimizi elimizden alacak mı?” sorusunun tarihi biraz eksik
Yeni bir teknoloji ortaya çıktığında bazı soruların geleceğini tahmin etmek zor değil. En büyüğü: “İşimizi elimizden alacak mı?” Bazı görevleri azaltacağı açık; bazı roller dönüşecek, bazı beceriler eskisi kadar değerli olmayacak. Bunu küçümsemek doğru olmaz. Ama tarihe yalnızca kaybolan işler üzerinden bakılırsa resmin yarısı görülür.
World Economic Forum'un Future of Jobs Report 2025 çalışmasında işverenlerden derlenen beklentiler, teknolojik ve diğer yapısal dönüşümler sonucunda 2030'a kadar 92 milyon rolün yerinden olabileceğini, buna karşılık 170 milyon yeni rol oluşabileceğini öngörüyor. Bunlar kesin gelecek rakamları değil, bir projeksiyon. Ancak raporda teknoloji ve yapay zeka alanlarının yanında eğitim, bakım ve farklı insan odaklı mesleklerde de büyüme beklentisinin bulunması önemli.
Rakamlardan daha ilginç olan tarih. Google'ın ilk yıllarında “SEO uzmanı” diye kaç çocuk kariyer planı yapıyordu? YouTube'un ilk videosu yüklenirken “YouTuber” bir meslek miydi? App Store'un ilk 500 uygulaması yayınlandığında uygulama ekonomisinin bugünkü ölçeğini kaç kişi öngörebilirdi? Sosyal medya ortaya çıkmadan influencer pazarlaması diye bir bütçe kalemi var mıydı? Bugün sıradan gelen birçok ekonomik faaliyet, oldukça yakın geçmişte ya yoktu ya da adı henüz konmamıştı. O nedenle yapay zeka döneminde “Hangi işler bitecek?” sorusunun yanına mutlaka ikinci soruyu koymak gerekiyor: Hangi işler ilk kez mümkün olacak?
Geleceğin en büyük şirketi bugün adı olmayan bir problemi çözüyor olabilir
Teknoloji tarihinde geriye bakıldığında başka bir şey daha görülüyor: Kazananlar her zaman temel teknolojiyi ilk icat edenler olmadı. Web'i Tim Berners-Lee geliştirdi, ama Yahoo başka bir fırsatı gördü. Arama Google'dan önce vardı, ama Google sıralamayı başka bir seviyeye taşıdı. Video YouTube'dan önce, akıllı telefon iPhone'dan önce, çevrimiçi sosyal topluluklar Facebook'tan önce, mesajlaşma ICQ'dan önce vardı. Ama bazı şirketler tam doğru anda insanların önündeki sürtünmeyi diğerlerinden biraz daha iyi gördü.
Bu yüzden bugün herkes temel model geliştirmek zorunda değil. Yapay zeka döneminin çok büyük şirketlerinden bazıları belki modeli geliştirenler değil, modelin ortaya çıkardığı yeni problemi çözenler olacak: Yapay zeka çıktısını güvenilir hale getirenler. Kurumsal bilgiyi yapay zeka için kullanılabilir hale getirenler. Veri mahremiyetini yönetenler. Eğitimde doğrulanabilir öğrenmeyi sağlayanlar. Küçük işletmelerin yapay zeka ajanlarıyla çalışmasını kolaylaştıranlar. Bugün pahalı olduğu için yapılamayan bir hizmeti yapay zeka sayesinde bin kat daha ucuzlatanlar. Ya da bunların hiçbiri; belki büyük fırsat henüz adı bile duyulmamış başka bir davranıştan çıkacak.
Peki yarın internete hâlâ “girecek” miyiz?
Yazının başına dönelim. Bir zamanlar internete giriyorduk. Sonra tarayıcıyı açtık. Sonra Google'ı, Facebook'u, Instagram'ı. Sonra telefonu elimize aldığımız anda zaten internetin içindeydik. Şimdi ise web'in kendisi yavaş yavaş görünmezleşmeye başlayabilir.
Düşünün: Bir seyahat planlarken on farklı siteyi siz mi açacaksınız, yoksa yapay zeka mı araştıracak? Bir ürün satın alırken yirmi incelemeyi siz mi okuyacaksınız, yoksa sistem kriterlerinize göre ortak noktaları mı çıkaracak? Şirketinizde bir rapor hazırlarken e-posta, dosya deposu, elektronik tablo, web ve sunum programı arasında siz mi dolaşacaksınız, yoksa hedefi söylediğinizde sistem bu araçların arasında sizin için mi çalışacak? Bu yöndeki sistemler artık teorik değil: 2026'daki ajan tabanlı çalışma araçları web sayfalarını okuyabiliyor, bağlı uygulama ve dosyalardan bilgi toplayabiliyor ve çok adımlı görevlerden tamamlanmış çıktılar üretmeye başlayabiliyor.
Bu durumda internet ortadan kalkmayacak; tam tersine, daha da önemli hale gelecek. Ama kullanıcıyla internet arasındaki ilişki değişebilir. Tıpkı elektrik kullanırken elektrik santralini düşünmediğimiz gibi, internet de giderek arka planda çalışan bir altyapıya dönüşebilir. Görünen şey ise kişisel bir yapay zeka katmanı olabilir: Sizi tanıyan, bağlamınızı anlayan, kaynaklara ulaşan ve hedefinizi eyleme dönüştürmenize yardım eden bir katman. Böyle bir dünyanın iş modellerini, eğitim biçimlerini, şirket yapılarını ve mesleklerini bugünden eksiksiz tahmin etmek mümkün değil. Geçmişte de edilemedi.
Otuz yıl sonra aynı yerdeyiz: Önümüzde yeni bir kapı var
1995'e geri dönelim. Bilgisayarın başında AltaVista'yı ilk kez gören ya da Yahoo'nun kategorileri arasında gezen birine önümüzdeki otuz yılda olacaklar anlatılsaydı: Bir gün dünyanın neredeyse bütün bilgisini saniyeler içinde arayabileceği; dünyanın başka ucundaki biriyle görüntülü konuşacağı; profesyonel kimliğinin internette yaşayan bir profile dönüşeceği; evinde çektiği bir videonun milyonlarca insana ulaşabileceği; hiç mağazası olmadan bütün dünyaya ürün satabileceği; telefonundaki küçük bir uygulamanın milyarlarca dolarlık bir şirkete dönüşebileceği; algoritmaların hangi filmi, müziği ya da videoyu seveceğini tahmin edeceği; ve sonunda bir bilgisayarla doğal dilde konuşup ona araştırma yaptıracağı, içerik ürettireceği, verileri analiz ettireceği ve giderek bazı işleri kendi adına yaptıracağı söylenseydi, ne kadarına inanırdı?
Bunların tamamı bir insan ömrünün oldukça küçük bir bölümünde gerçekleşti. Bu nedenle 2035'i bugünden kesin biçimde tarif etmeye çalışmak pek gerçekçi değil; bugün yapılan tahminlerin bir bölümü yanlış çıkacak. Ama geçmiş, geleceğin ayrıntılarını vermese de bir örüntü gösteriyor: Önce yeni teknoloji geliyor, bir sürtünmeyi azaltıyor, insanların davranışı değişiyor, yeni davranışın çevresinde fırsatlar oluşuyor, ardından yeni problemler ortaya çıkıyor ve o problemler bir sonraki dönüşümün hammaddesine dönüşüyor. Yahoo'dan Google'a, mIRC ve ICQ'dan sosyal ağlara, YouTube'dan içerik üreticisi ekonomisine, akıllı telefondan uygulama ekonomisine, algoritmik akışlardan kişiselleştirilmiş internete ve şimdi oradan yapay zekaya.
Belki bu nedenle bugün yapay zeka konusunda sorulması gereken en ilginç soru “Yapay zeka neleri yapabilecek?” değil. Biraz daha ileri gidelim: “Yapay zeka sayesinde artık mümkün olduğu halde, bizim henüz yapmayı düşünmediğimiz şey ne?”
Çünkü teknoloji tarihinin öğrettiği bir şey varsa, o da şu: Bir sonraki büyük fırsat geldiğinde üzerinde çoğu zaman büyük harflerle “GELECEK” yazmıyor. Bazen küçük bir arama kutusu olarak geliyor. Bazen anlamsız gibi görünen 19 saniyelik bir video olarak. Bazen 500 uygulamalık yeni bir mağaza olarak. Bazen “Şu anda ne yapıyorsun?” diye soran basit bir web sitesi olarak. Bazen de ekranda bekleyen boş bir sohbet kutusu olarak. İlk görüldüğünde çoğu zaman neye dönüşeceği bilinmiyor. Sonra insanlar onu kullanmaya başlıyor, davranış değişiyor ve yıllar sonra geriye dönüp “Her şey aslında orada başlamış” deniyor.
Bugün de büyük ihtimalle böyle bir dönemin içindeyiz. Bir sonraki büyük değişimin ne olacağı henüz bilinmiyor, ama parçalarının çoktan önümüzde olduğuna dair güçlü işaretler var. Belki yapılması gereken geleceği kusursuz biçimde tahmin etmeye çalışmak değil, daha iyi bir şey: Değişen davranışı fark etmek. Çünkü geçmişte yeni fırsatları yaratan şey çoğu zaman teknolojiyi herkesten önce görmek değildi; teknolojinin insanlarda neyi değiştirdiğini herkesten önce fark etmekti. Otuz yılı aşkın dijital dönüşümün ardından soru yine aynı: Şu anda biz fark etmeden hangi davranış değişiyor?
Sık sorulan sorular
Copernic neydi ve neden bugünün yapay zeka ajanlarına benzetiliyor?
Copernic, 1990'ların sonunda bilgisayara kurulan bir meta-arama yazılımıydı: Kullanıcının sorgusunu AltaVista, Lycos, Yahoo gibi birçok arama servisine aynı anda gönderir, sonuçları toplar, tekrarları ayıklar ve tek listede sunardı. Bugünün yapay zeka ajanları da kullanıcının hedefini alıp web, dosyalar, takvim ve bağlı uygulamalar arasında dolaşarak sonucu getiriyor. Kapasite farkı çok büyük olsa da “sen tek tek dolaşma, ben gidip getireyim” fikri aynı.
Yapay zeka öğrencinin ödevini yapıyorsa öğrenme gerçekleşmiş sayılır mı?
OECD'nin Digital Education Outlook 2026 raporuna göre hayır, otomatik olarak sayılmaz. Genel amaçlı yapay zeka araçları ortaya çıkan ürünün kalitesini yükseltebilir, ama görev pedagojik rehberlik olmadan tümüyle makineye devredildiğinde performans artarken gerçek öğrenme kazanımı oluşmayabilir. Öğrenmeyi destekleyen kullanım, öğrenciyi düşündürmeye devam eden ve öğrenme hedefine göre tasarlanmış kullanımdır.
Yapay zeka okuryazarlığı prompt yazmayı öğrenmek mi?
Prompt yazmak bugünkü arayüzlerin geçici bir katmanı. OECD ve Avrupa Komisyonu'nun 2026'da yayımladığı AI Literacy Framework, yapay zeka okuryazarlığını sistemleri anlama, çıktıları eleştirel değerlendirme ve teknolojiyi etik ve yaratıcı biçimde kullanma yetkinliklerinin bütünü olarak tanımlıyor. Kalıcı beceri, hangi işi makineye verip hangisini kendinizin yapması gerektiğini bilmek ve çıktı ile bilgi arasındaki farkı ayırt edebilmek.
Yapay zeka işleri yok edecek mi, yoksa yeni işler mi yaratacak?
World Economic Forum'un Future of Jobs Report 2025 projeksiyonu, 2030'a kadar 92 milyon rolün yerinden olabileceğini ve 170 milyon yeni rol oluşabileceğini öngörüyor; bunlar işveren beklentilerine dayanan tahminler, kesin sonuçlar değil. Tarih ise ikinci soruyu daha ilginç kılıyor: SEO uzmanlığı, YouTuber'lık ve mobil uygulama geliştiriciliği gibi bugün sıradan görülen meslekler, ilgili teknoloji çıktığında henüz yoktu.
Kaynaklar
- CERN, The birth of the Web ve web yazılımının kamuya açılması (30 Nisan 1993)
- Yahoo Inc., şirket tarihçesi (1994); Web Design Museum ve Internet Archive, AltaVista (15 Aralık 1995)
- Los Angeles Times, Copernic 99 incelemesi (1999); Copernic Technologies kurumsal sayfaları (1997-1999, Internet Archive)
- Google, şirket hikayesi (1998)
- mIRC, Khaled Mardam-Bey'in notu (28 Şubat 1995)
- WIRED, AOL'in Mirabilis'i satın alması (Haziran 1998)
- Wikimedia Foundation, Wikipedia 25. yıl (15 Ocak 2026)
- LinkedIn, kuruluş ve ilk ay üye sayısı (5 Mayıs 2003); Harvard Gazette, The Facebook (2004-2006)
- YouTube, Me at the zoo (23 Nisan 2005) ve Partner Program (2007); Khan Academy destek merkezi, kuruluş hikayesi (2004-2008)
- Twitter, ilk tweet (Mart 2006); Facebook, News Feed duyurusu (Eylül 2006)
- Linden, Smith ve York, Amazon.com Recommendations: Item-to-Item Collaborative Filtering, IEEE Internet Computing (2003); Netflix Prize (2006)
- TikTok, For You akışı nasıl çalışır
- Apple, iPhone tanıtımı (9 Ocak 2007) ve App Store onuncu yıl değerlendirmesi (2008-2018)
- OpenAI, ChatGPT araştırma ön izlemesi (30 Kasım 2022); bellek sistemi (Haziran 2026); OpenAI Help Center, ajan araçları (2025-2026)
- Google Türkiye, Gemini Kişisel Zeka (Nisan 2026)
- OECD, Digital Education Outlook 2026 (19 Ocak 2026); OECD ve Avrupa Komisyonu, AI Literacy Framework (2026)
- World Economic Forum, Future of Jobs Report 2025
Dönem görselleri Internet Archive Wayback Machine'deki arşiv kopyalarından, ilgili sitelerin o tarihteki hâliyle alınmıştır.